İçeriğe geç

Ücretsiz ve açık kaynak

MIT lisansı. Kullanmak, değiştirmek ve paylaşmak serbest. Kaynak kodu GitHub'da.

Videolardaki değiştirilmiş yüzleri tespit etmek.

xdfdet, EfficientNet-B4 tabanlı bir yüz manipülasyonu tespit modelini eğitmenin dokuz yolunu tespit başarısı, olasılık güvenilirliği ve tahminlerle ilişkili yüz bölgelerine göre karşılaştırıyor.

Makaleyi kıdemli yapay zekâ araştırmacısı Mert Kaya ile Venera Adanova (TED Üniversitesi) yazdı · UBMK 2026’da İstanbul’da sunuldu ve IEEE Xplore’da yayımlandı.

KodModellerTez

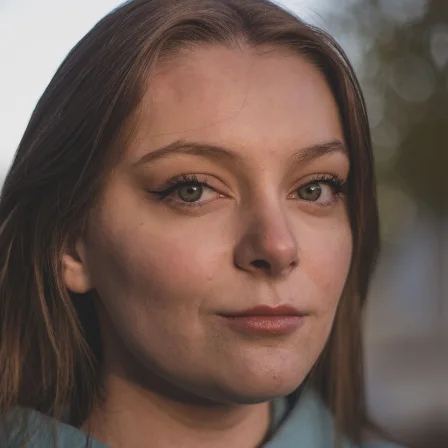
Görüntü çeşitlendirme ve siyah dolgulu maskeleme modelinin ısı haritası (Grad-CAM). Bu gerçek portrede gözleri ve kaşları öne çıkarır ve gerçek tahmini verir.Fotoğraf: Pexels

Çalışma nasıl yürütüldü

Yüksek riskli durumlarda bir dedektörün kararı, ancak biri onu kontrol edebildiğinde işe yarar.

  1. 1

    2.000 videodan yüzler

    Yaygın kullanılan bir yapay yüz manipülasyonu video veri kümesini (FaceForensics++) kullanıyoruz: her biri değiştirilmiş bir kopyayla eşleştirilen 1.000 gerçek video. Yüzleri buluyor, hizalıyor ve kırpıyoruz.

    Gerçek kare
    Manipüle edilmiş kare
  2. 2

    Dokuz eğitim yapılandırması

    Aynı tespit modelini (EfficientNet-B4) dokuz yapılandırmada, her biri için üç kez eğitiyoruz. Eğitim görüntülerini değiştirme (veri çeşitlendirme) ve yüzün bir bölümünü dolgulu bir alanla kapatma (cutout) yöntemlerini karşılaştırıyoruz.

    Sahte karede cutout
    Gerçek karede yıldız cutout
  3. 3

    Her kararı açıklamak

    Isı haritaları (Grad-CAM), tahminlerle ilişkili görüntü bölgelerini gösterir. Harita yoğunluğunu sekiz yüz bölgesinde ölçüyoruz.

    Grad-CAM aktivasyonu
    Sekiz yüz bölgesi
Tüm işlem hattıYüz hazırlama, tahmin ve açıklama için yedi adım

Her görsel, xdfdet kodunun gerçek bir Pexels portresi üzerindeki çıktısıdır. FaceForensics++ örnekleri tezden alınmıştır.

  1. 01

    Yüz tespiti

    Yüz tespit aracı MTCNN, yüzleri hizalar ve kırpar. Model, her videodan eşit aralıklarla seçilen 12 kareyi kullanır.

    Tespit edilen yüz ve gözler
    Hizalanmış ve kırpılmış yüz
  2. 02

    Yüz noktaları

    Yüz analiz kütüphanesi dlib, sekiz yüz bölgesini tanımlayan noktaları işaretler.

    68 nokta ve bölge sınırları
    Puanlanan bölge maskeleri. Çene hattı poligonu, yüzün alt kısmından geçen düz bir kenarla kapanır; bu yüzden çene skoru burun ve ağız bölgeleriyle örtüşür.
  3. 03

    Görüntü benzerliği (SSIM)

    Benzerlik haritası, değiştirilmiş kareyi gerçek kaynağıyla karşılaştırır. Koyu alanlar neredeyse aynıdır ve maskenin yerini belirler.

    Gerçek kare
    SSIM farkı
    Manipüle edilmiş kare

    FaceForensics++ kareleri, tezden

  4. 04

    Dolgulu maskeleme (cutout)

    Sahte karelerde en benzer alanın üzerine noktalardan çizilen poligon siyah, beyaz ya da rastgele piksellerle doldurulur. Gerçek karelere aynı dolguyla, yarıçapı 8 ile 15 piksel arasında olan bir yıldız eklenir.

    Siyah dolgu
    Beyaz dolgu
    Rastgele dolgu
    Gerçek karede yıldız
  5. 05

    Eğitim görüntülerini çeşitlendirme

    Albumentations kütüphanesi gürültü, bulanıklık, renk kayması, yansıtma ve küçük döndürmeler ekler. Yoğun ayar bunları dört ila beş kat daha sık uygular.

    Girdi
    Standart, rastgele bir örnek
    Yoğun, rastgele bir örnek
  6. 06

    Video düzeyinde tahmin

    Yüz manipülasyonu tespit modeli EfficientNet-B4, 12 kareyi puanlar ve ortalamalarını video puanı olarak kullanır. 0,5 altı sahte demektir.

    12 kırpılmış yüz
    Kare başına EfficientNet-B4
    12 kare skoru
    Ortalama
    0,9997
    Video skoru
  7. 07

    Grad-CAM

    Bu ısı haritası yöntemi, tahminle ilişkili bölgeleri öne çıkarır. Üç karenin haritalarını ortalayıp her yüz bölgesinde ölçüyoruz.

    Girdi
    Görüntü çeşitlendirme ve siyah dolgunun Grad-CAM haritası

Ne bulduk

Gerçek ve sahte videoları ayırma başarısını (AUC), bir eşikte sınıflandırmayı (F1) ve olasılık hatalarını (Brier skoru ve log loss) ölçüyoruz.

Görüntü çeşitlendirme ve siyah maskeleme tespiti iyileştiriyor

Görüntü çeşitlendirme ve siyah dolgulu maskeleme modeli, dört ölçütte de temel modelden daha iyi sonuç veriyor.

Görüntü çeşitlendirme ve siyah dolgulu maskeleme: AUC 0,8971. Temel model: 0,8678. İkisi de üç koşunun ortalaması; 1,0 kusursuz ayrım, 0,5 şans düzeyidir.

Metrikler farklı sıralıyor

Standart görüntü çeşitlendirme modeli AUC sıralamasında son, F1 sıralamasında ikinci. Ölçütler tespitin farklı yönlerini değerlendiriyor.

Görüntü çeşitlendirme ve rastgele dolgulu maskelemede log loss 0,4656. Görüntü çeşitlendirme ve siyah dolgulu maskelemede AUC 0,8971.

AyrıntılarKalibrasyon

Kalibrasyon, olasılıkların gözlenen sonuçlarla ne kadar örtüştüğünü anlatır. Örneğin %90 olasılık verilen tahminlerin yaklaşık onda dokuzunun doğru çıkması beklenir. Brier skoru ve log loss, olasılık hatalarını ölçer.

Dedektörlerin buna neden ihtiyacı varBu, bir olasılığa ne kadar güvenilebileceğini değerlendirmeye yardımcı olur.

Nokta: üç çalıştırmanın ortalaması. Çizgi: bir standart sapma. ↑ yüksek değer, ↓ düşük değer daha iyidir. 150 video çiftinden oluşan FaceForensics++ test kümesi.

Farklı bir video veri kümesinde test

Makaleden sonra, Deepfake Detection Challenge (DFDC) veri setinden daha önce görülmemiş 398 videoyla yapılan bir kontrol: aynı sekiz model 0,60 ila 0,66 AUC’ye ulaşıyor (FaceForensics++’ta 0,86 ila 0,90) ve sahtelerin %15 ila %36’sını yakalıyor.

Kaggle notebook

Burun bölgesinde gizli bir ödünleşim

Burun, hem doğru hem yanlış kararlarda en aktif bölgeler arasında.

Makale, genel tespit puanlarının belirli yüz bölgelerine bağımlılığı gizleyebildiğini gösteriyor.

Bir yüz, dört yapılandırmaBir portrede ısı haritaları ve yüz bölgesi ölçümleri

Dördü de bu portreyi gerçek olarak sınıflandırıyor, ama farklı yerlere bakıyorlar. Görüntü çeşitlendirme ve siyah dolgulu maskeleme yapılandırması gözlere ve kaşlara odaklanıyor; yalnızca siyah dolgulu cutout ise neredeyse hiç aktivasyon üretmiyor.

Temel model

Gerçek olma olasılığı 0,9947

Bölgelere göre ısı haritası etkinliği (Grad-CAM, 0 ile 100)

  • Dış ağız47
  • İç ağız47
  • Çene44

Standart veri artırma

Gerçek olma olasılığı 0,9999

Bölgelere göre ısı haritası etkinliği (Grad-CAM, 0 ile 100)

  • Sol kaş84
  • Sol göz84
  • Sağ göz78

Cutout, siyah dolgu

Gerçek olma olasılığı 0,7315

Bölgelere göre ısı haritası etkinliği (Grad-CAM, 0 ile 100)

  • Sol göz7
  • Sol kaş6
  • Çene1

Veri artırma + siyah dolgu

Gerçek olma olasılığı 0,9999

Bölgelere göre ısı haritası etkinliği (Grad-CAM, 0 ile 100)

  • Sol göz79
  • Sol kaş74
  • Burun67

Tek bir portre yalnızca bir örnektir. Makale, Grad-CAM’in ortalamasını dört gruptaki test videoları üzerinden alır: yakalanan sahteler, kaçırılan sahteler, doğru kabul edilen gerçekler ve yanlışlıkla sahte sayılan gerçekler.

Dokuz yapılandırmanın tamamıGörüntü değişiklikleri ve dolgulu maskeler, tespit puanlarıyla (AUC)

Veri artırma: Yok

Cutout yok

0,8678

Veri artırma: Yalnızca yansıtma

Rastgele dolgu

0,8711

Siyah dolgu

0,8666

Beyaz dolgu

0,8639

Veri artırma: Standart

Cutout yok

0,8610

Rastgele dolgu

0,8837

Siyah dolgu

0,8971
vurgulanan ayar

Beyaz dolgu

0,8734

Veri artırma: Yoğun

Cutout yok

0,8718

AUC değerleri makalede raporlandığı gibidir. Makale yalnızca cutout kullanan yapılandırmaları veri artırmasız olarak listeler, ancak bu yapılandırmalarda rastgele yatay yansıtma yine de uygulanmıştır.

Kendi gözünüzü sınayın

Gerçek fotoğraf, ekran görüntüsü ve klipleri yapay zekâ üretimi olanlardan ayırın. Ardından yapay zekâyla üretilen veya değiştirilen medyaya ilişkin sayıları tahmin edin.

PortrelerKalabalıklarHayvanlarManzaralarVideo kliplerSporAnimasyonVideo oyunlarıWeb siteleri

Bir videoyu puanlayın

İki komut, veri seti gerekmez. Ağırlıklar ilk kullanımda Hugging Face’ten iner.

  1. 1

    Kurulum

    Python 3.11 ile 3.13 arası.

    pip install git+https://github.com/mertkayacs/xdfdet
  2. 2

    Bir videoda çalıştırın

    Gerçek olma olasılığını ve kararı yazdırır; yüz bölgesi ölçümleriyle birlikte bir ısı haritası kaydeder.

    xdfdet predict video.mp4 --gradcam cam.png
Çalışmayı yeniden üretinAraştırma veri kümesi ve grafik işlemcisi (GPU) gerekir
  1. 3

    Veriyi edinin

    FaceForensics++’ı yazarlarından talep edin. Veri seti yalnızca araştırma amaçlı lisanslıdır.

  2. 4

    Yüzleri kırpın

    Video başına 32 kare, 224×224 piksel.

    xdfdet crop raw/ faces/
  3. 5

    Eğitin

    Dokuz yapılandırmadan birini seçin. Bir Colab T4 GPU’su yeterlidir.

    xdfdet train --data faces/ --config aug-cutout-black --out model.keras
  4. 6

    Değerlendirin ve açıklayın

    Dört metrik ve doğru ile yanlış tahminler için bölge başına Grad-CAM.

    xdfdet evaluate --data faces/ --model model.keras
    xdfdet analyze --data faces/ --model model.keras --out regions.json

Rakamları karşılaştırmadan önce orijinal çalıştırmalara ilişkin notları okuyun. Her orijinal çalıştırma kendi rastgele eğitim/test ayrımını kullandı.

Eğitilmiş modellerSekiz dedektör, CC BY-NC 4.0 lisansıyla, ticari olmayan araştırmalar için.

Dokuz eğitim ayarı, sayılarla

Bu puanlar çalışmadaki dokuz ayarı karşılaştırır. AUC farklı eşiklerdeki sıralama başarısını, F1 seçilen eşikteki sınıflandırma başarısını ölçer.

Görüntü çeşitlendirme ve siyah maskeleme AUC puanı; 3 koşunun ortalaması
0,8971 ± 0,0064
Kaynak
Aynı ayarın F1 puanı; 3 koşunun ortalaması
0,8429 ± 0,0101
Kaynak
Yayımlanan EfficientNet-B4 modeli; CC BY-NC 4.0
8
Kaynak
FaceForensics++ videosu: 1.000 gerçek ve 1.000 değiştirilmiş
2.000
Kaynak
Daha önce görülmemiş DFDC videosu; modellerin AUC puanları 0,60 ile 0,66 arasında
398
Kaynak
Bu modeller daha önce görmedikleri videolarda sınandığında tespit başarısı düşüyor.

Özgün yapılandırmaların test bölümleri birbirinden farklı ve sabit rastgelelik tohumu olmadan seçilmiş. Makaledeki üç koşunun ortalaması, yayımlanan ağırlıkların tek koşuluk sonuçlarından farklıdır. Grad-CAM tahminle ilişkili bölgeleri gösterir; bir ısı haritası videonun gerçek olduğunu kanıtlamaz.

Bu çalışmaya atıf yapınYüksek lisans tezinin DOI'si ve IEEE UBMK 2026'da yayımlanan makale
@inproceedings{kaya2026augmentation,
  title     = {Augmentation and Cutout in Deepfake Detection: A Comparative Study of
               Accuracy, Calibration, and Attention},
  author    = {Kaya, Mert and Adanova, Venera},
  booktitle = {2026 11th International Conference on Computer Science and Engineering (UBMK)},
  pages     = {78--83},
  year      = {2026},
  publisher = {IEEE},
  doi       = {10.1109/UBMK71847.2026.11745298},
  url       = {https://ieeexplore.ieee.org/document/11745298}
}

@mastersthesis{kaya2025xdfdet,
  title  = {Explainable Deepfake Detection Using Frame Level CNN Models:
            A Comparative Study of Augmentation and Cutout Techniques},
  author = {Kaya, Mert},
  school = {TED University},
  year   = {2025},
  doi    = {10.5281/zenodo.18998566}
}

Açıklanabilir deepfake tespiti hakkında sorular

xdfdet çalışmasındaki dokuz eğitim ayarı nasıl karşılaştırılıyor?

Görüntü çeşitlendirme ile siyah dolgulu maskelemeyi birleştiren ayarın üç FaceForensics++ koşusundaki ortalama AUC değeri 0,8971; başlangıç EfficientNet-B4 modelinde ise 0,8678. Bu karşılaştırma söz konusu deneyle sınırlı. Yayımlanan modellerin daha önce görmediği 398 DFDC videosunda AUC 0,60 ile 0,66 arasında kaldığından, değerlendirme veri kümesi sonucu belirgin biçimde etkiliyor.

xdfdet bir deepfake tahminini nasıl açıklıyor?

xdfdet, her tahminle ilişkili görüntü bölgelerini göstermek için Grad-CAM ısı haritalarını kullanıyor. Analiz, 68 yüz noktasıyla tanımlanan sekiz bölgedeki etkinliği ölçüyor: gözler, kaşlar, burun, ağız ve çene. Bu haritalar modelin davranışını incelemeyi kolaylaştırıyor. Görüntünün hangi yöntemle değiştirildiğini kanıtlamıyor ve modelin verdiği kararın doğru olacağını garanti etmiyor. Sonucu değerlendirirken kaynak videoyu ve diğer bulguları da incelemek gerekiyor.

xdfdet modellerini indirip kendi bilgisayarımda çalıştırabilir miyim?

Hugging Face ve Kaggle üzerinde sekiz EfficientNet-B4 modeli var. Python paketini GitHub deposundan kurup xdfdet predict komutunu bir video üzerinde çalıştırarak gerçek olma olasılığını, kararı ve isteğe bağlı Grad-CAM görselini alabilirsiniz. Paket Python 3.11 ile 3.13 arasındaki sürümleri destekliyor. Model ağırlıkları ilk kullanımda indiriliyor; tahmin yapmak için eğitim veri kümesini ayrıca edinmeniz gerekmiyor.

xdfdet ticari deepfake tespiti için ücretsiz mi?

xdfdet kodu MIT lisansıyla, yayımlanan sekiz modelin ağırlıkları ise CC BY-NC 4.0 lisansıyla sunuluyor. Modeller, kullanım koşulları ticari olmayan araştırmayla sınırlı olan FaceForensics++ üzerinde eğitildi. Kodu inceleyebilir ve modelleri araştırma amacıyla kullanabilirsiniz. Yayımlanan ağırlıkları ticari bir üründe kullanmak için ilgili hak sahiplerinden izin almanız gerekir. Kodun lisansı ile model ağırlıklarının lisansını ayrı ayrı değerlendirin.

xdfdet hangi veri kümesini ve model mimarisini kullanıyor?

Çalışma, FaceForensics++ veri kümesinden 1.000 gerçek video ve bunlarla eşleştirilmiş 1.000 değiştirilmiş kopya olmak üzere 2.000 video kullanıyor. MTCNN yüzleri bulup hizalıyor ve 224'e 224 piksel boyutunda kırpıyor. EfficientNet-B4, 12 kareyi ayrı ayrı puanlayıp ortalamalarını video tahmini olarak veriyor. Dokuz eğitim ayarında mimari aynı kalırken görüntü çeşitlendirme ve maskeleme yöntemleri değişiyor.

xdfdet tezine ve UBMK makalesine nasıl atıf yapabilirim?

Mert Kaya'nın TED Üniversitesi'ndeki 2025 yüksek lisans tezinin DOI'si 10.5281/zenodo.18998566. Mert Kaya ve Venera Adanova'nın Augmentation and Cutout in Deepfake Detection: A Comparative Study of Accuracy, Calibration, and Attention başlıklı makalesi İstanbul'daki UBMK 2026'da sunuldu ve IEEE Xplore'da 78-83. sayfalarda yayımlandı. DOI'si 10.1109/UBMK71847.2026.11745298. Bu sayfadaki BibTeX kayıtlarını kullanın.