Zum Inhalt springen

Kostenlos und Open Source

MIT-Lizenz. Frei nutzbar, veränderbar und teilbar. Quellcode auf GitHub.

Manipulierte Gesichter in Videos erkennen.

xdfdet vergleicht neun Wege, einen EfficientNet-B4-Detektor für Gesichtsmanipulationen zu trainieren, anhand von Erkennungsleistung, Zuverlässigkeit der Wahrscheinlichkeiten und den mit den Vorhersagen verbundenen Gesichtsregionen.

Von Senior-KI-Forscher Mert Kaya und Venera Adanova, TED University verfasst · Auf der UBMK 2026 in Istanbul vorgestellt und in IEEE Xplore veröffentlicht.

CodeModelleMasterarbeit

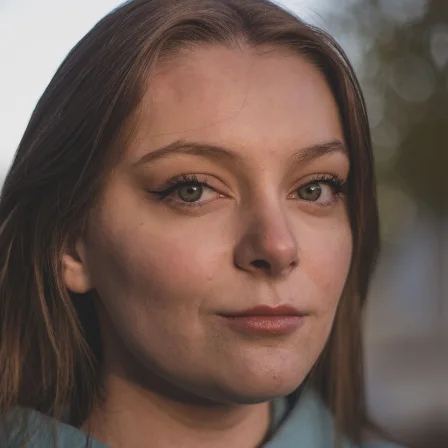
Eine Heatmap (Grad-CAM) des Detektors mit Bildvariation und schwarzen Abdeckungen. Bei diesem echten Porträt hebt sie Augen und Augenbrauen hervor; das Modell sagt echt voraus.Foto: Pexels

So funktioniert die Studie

Wo viel auf dem Spiel steht, hilft das Ergebnis eines Detektors nur, wenn jemand es nachprüfen kann.

  1. 1

    Gesichter aus 2.000 Videos

    Wir nutzen einen verbreiteten Datensatz für manipulierte Gesichtsvideos (FaceForensics++): 1.000 echte Videos, jeweils mit einer manipulierten Kopie. Wir erkennen, richten aus und schneiden die Gesichter zu.

    Echtes Einzelbild
    Manipuliertes Einzelbild
  2. 2

    Neun Trainingsvarianten

    Wir trainieren denselben Detektor (EfficientNet-B4) in neun Varianten mit je drei Durchläufen. Wir verändern Trainingsbilder (Datenaugmentation) und decken Gesichtsteile mit gefüllten Flächen ab (Cutout).

    Cutout auf einem gefälschten Einzelbild
    Stern-Cutout auf einem echten Einzelbild
  3. 3

    Jede Entscheidung erklären

    Heatmaps (Grad-CAM) zeigen Bildregionen, die mit einer Vorhersage verbunden sind. Wir messen ihre Intensität in acht Gesichtsregionen.

    Grad-CAM-Aktivierung
    Acht Gesichtsregionen
Die gesamte PipelineGesichtsvorbereitung, Vorhersage und Erklärung in sieben Schritten

Jedes Bild ist die Ausgabe des xdfdet-Codes auf einem echten Pexels-Porträt. Die FaceForensics++-Beispiele stammen aus der Masterarbeit.

  1. 01

    Gesichtsdetektion

    Das Werkzeug zur Gesichtserkennung MTCNN richtet Gesichter aus und schneidet sie zu. Das Modell nutzt zwölf gleichmäßig verteilte Bilder pro Video.

    Gefundenes Gesicht und Augen
    Ausgerichteter Ausschnitt
  2. 02

    Gesichtslandmarken

    Die Bibliothek zur Gesichtsanalyse dlib markiert die Punkte, die acht Gesichtsregionen definieren.

    68 Landmarken und Regionsgrenzen
    Regionsmasken wie bewertet. Das Kieferpolygon wird durch eine gerade Kante quer über das untere Gesicht geschlossen, deshalb überschneidet sich der Kieferwert mit Nase und Mund.
  3. 03

    Bildähnlichkeit (SSIM)

    Eine Ähnlichkeitskarte vergleicht jedes manipulierte Bild mit seiner echten Vorlage. Dunkle Bereiche sind fast identisch und bestimmen die Platzierung der Abdeckung.

    Echtes Einzelbild
    SSIM-Differenz
    Manipuliertes Einzelbild

    FaceForensics++-Bilder, aus der Masterarbeit

  4. 04

    Gefüllte Abdeckungen (Cutout)

    Auf gefälschten Einzelbildern wird ein Landmarken-Polygon über dem ähnlichsten Bereich schwarz, weiß oder mit Zufallspixeln gefüllt. Echte Einzelbilder erhalten einen Stern mit einem Radius von 8 bis 15 Pixeln und derselben Füllung.

    Schwarze Füllung
    Weiße Füllung
    Zufallsfüllung
    Stern auf einem echten Einzelbild
  5. 05

    Veränderte Trainingsbilder (Augmentation)

    Die Bibliothek Albumentations fügt Rauschen, Unschärfe, Farbverschiebungen, Spiegelungen und kleine Drehungen hinzu. Die intensive Stufe wendet sie vier- bis fünfmal so oft an.

    Eingabe
    Standard, ein Zufallsbeispiel
    Intensiv, ein Zufallsbeispiel
  6. 06

    Vorhersage auf Videoebene

    Der Detektor für Gesichtsmanipulationen EfficientNet-B4 bewertet zwölf Bilder und mittelt sie zu einem Videowert. Unter 0,5 bedeutet gefälscht.

    12 Gesichtsausschnitte
    EfficientNet-B4 pro Bild
    12 Einzelwerte
    Mittelwert
    0,9997
    Videowert
  7. 07

    Grad-CAM

    Diese Heatmap-Methode hebt Regionen hervor, die mit einer Vorhersage verbunden sind. Wir mitteln Karten aus drei Bildern und messen sie je Gesichtsregion.

    Eingabe
    Grad-CAM mit Bildvariation und schwarzer Abdeckung

Was wir gefunden haben

Wir messen die Trennung echter und gefälschter Videos (AUC), die Klassifikation bei einem Schwellenwert (F1) und Wahrscheinlichkeitsfehler (Brier-Score und Log Loss).

Bildvariation und schwarze Abdeckungen verbessern die Erkennung

Der Detektor mit Bildvariation und schwarzen Abdeckungen übertrifft den Basisdetektor bei allen vier Kennzahlen.

Bildvariation und schwarze Abdeckungen: AUC 0,8971. Basisdetektor: 0,8678. Beide Werte sind Mittel aus drei Durchläufen; 1,0 bedeutet perfekte Trennung, 0,5 Zufall.

Die Metriken sind sich uneinig

Der Detektor mit Standardaugmentation liegt bei AUC auf dem letzten und bei F1 auf dem zweiten Platz. Die Kennzahlen erfassen verschiedene Aspekte der Erkennung.

Der Detektor mit Bildvariation und zufälliger Abdeckung erreicht einen Log Loss von 0,4656. Der Detektor mit Bildvariation und schwarzer Abdeckung erreicht eine AUC von 0,8971.

Im DetailKalibrierung

Kalibrierung beschreibt, wie gut Wahrscheinlichkeiten mit beobachteten Ergebnissen übereinstimmen. Vorhersagen mit 90 % sollten beispielsweise etwa neun von zehn Mal richtig sein. Brier-Score und Log Loss messen Wahrscheinlichkeitsfehler.

Warum Detektoren das brauchenDas hilft einzuschätzen, wie viel Vertrauen eine Wahrscheinlichkeit verdient.

Punkt: Mittel aus drei Läufen. Linie: eine Standardabweichung. ↑ höher ist besser, ↓ niedriger ist besser. FaceForensics++-Testdatensatz mit 150 Videopaaren.

Test mit einem anderen Videodatensatz

Eine Prüfung nach dem Paper, mit 398 unbekannten Videos der Deepfake Detection Challenge (DFDC): Dieselben acht Modelle erreichen eine AUC von 0,60 bis 0,66, gegenüber 0,86 bis 0,90 auf FaceForensics++, und erkennen 15 bis 36 % der Fälschungen.

Kaggle-Notebook

Ein verborgener Zielkonflikt in der Nasenregion

Die Nase gehört bei richtigen wie bei falschen Entscheidungen zu den aktivsten Regionen.

Die Studie zeigt, dass gesamte Erkennungswerte die Abhängigkeit von einzelnen Gesichtsregionen verdecken können.

Ein Gesicht, vier VariantenHeatmaps und Messungen der Gesichtsregionen an einem Porträt

Alle vier stufen dieses Porträt als echt ein, schauen aber auf unterschiedliche Stellen. Die Variante mit Bildvariation und schwarzer Abdeckung konzentriert sich auf Augen und Augenbrauen; die schwarze Abdeckung allein wird kaum aktiv.

Basisdetektor

Wahrscheinlichkeit für echt 0,9947

Heatmap-Aktivierung nach Region (Grad-CAM, 0 bis 100)

  • Äußerer Mund47
  • Innerer Mund47
  • Kieferlinie44

Standard-Augmentierung

Wahrscheinlichkeit für echt 0,9999

Heatmap-Aktivierung nach Region (Grad-CAM, 0 bis 100)

  • Linke Augenbraue84
  • Linkes Auge84
  • Rechtes Auge78

Cutout, schwarze Füllung

Wahrscheinlichkeit für echt 0,7315

Heatmap-Aktivierung nach Region (Grad-CAM, 0 bis 100)

  • Linkes Auge7
  • Linke Augenbraue6
  • Kieferlinie1

Augmentierung + schwarze Füllung

Wahrscheinlichkeit für echt 0,9999

Heatmap-Aktivierung nach Region (Grad-CAM, 0 bis 100)

  • Linkes Auge79
  • Linke Augenbraue74
  • Nase67

Ein einzelnes Porträt dient nur der Veranschaulichung. Das Paper mittelt Grad-CAM über die Testvideos in vier Gruppen: erkannte Fälschungen, übersehene Fälschungen, richtig akzeptierte echte Videos und fälschlich markierte echte Videos.

Alle neun VariantenBildveränderungen und Abdeckungen mit Erkennungswerten (AUC)

Augmentierung: Keine

Kein Cutout

0,8678

Augmentierung: Nur Spiegelung

Zufallsfüllung

0,8711

Schwarze Füllung

0,8666

Weiße Füllung

0,8639

Augmentierung: Standard

Kein Cutout

0,8610

Zufallsfüllung

0,8837

Schwarze Füllung

0,8971
markierte Variante

Weiße Füllung

0,8734

Augmentierung: Intensiv

Kein Cutout

0,8718

AUC wie im Paper angegeben. Das Paper führt die Varianten nur mit Cutout ohne Augmentierung; sie nutzten aber zufällige horizontale Spiegelungen.

Testen Sie Ihren Blick für Fälschungen

Unterscheiden Sie echte Fotos, Bildschirmaufnahmen und Clips von KI-generierten Inhalten. Schätzen Sie danach Zahlen zu Medien, die KI erzeugt oder verändert.

PorträtsMenschenmengenTiereLandschaftenVideoclipsSportAnimationVideospieleWebsites

Ein Video bewerten

Zwei Befehle, kein Datensatz nötig. Die Gewichte werden beim ersten Aufruf von Hugging Face geladen.

  1. 1

    Installieren

    Python 3.11 bis 3.13.

    pip install git+https://github.com/mertkayacs/xdfdet
  2. 2

    Auf ein Video anwenden

    Gibt die Wahrscheinlichkeit für echt und die Entscheidung aus und speichert eine Heatmap mit Messungen der Gesichtsregionen.

    xdfdet predict video.mp4 --gradcam cam.png
Die Studie reproduzierenBenötigt den Forschungsdatensatz und einen Grafikprozessor (GPU)
  1. 3

    Daten beschaffen

    FaceForensics++ bei den Autoren anfragen. Der Datensatz ist nur für die Forschung lizenziert.

  2. 4

    Gesichter ausschneiden

    32 Einzelbilder pro Video, 224×224 Pixel.

    xdfdet crop raw/ faces/
  3. 5

    Trainieren

    Eine der neun Varianten wählen. Eine Colab-T4-GPU genügt.

    xdfdet train --data faces/ --config aug-cutout-black --out model.keras
  4. 6

    Auswerten und erklären

    Die vier Metriken sowie Grad-CAM je Region für richtige und falsche Vorhersagen.

    xdfdet evaluate --data faces/ --model model.keras
    xdfdet analyze --data faces/ --model model.keras --out regions.json

Vor dem Vergleich von Zahlen bitte die Hinweise zu den ursprünglichen Läufen lesen. Jeder ursprüngliche Lauf nutzte seine eigene zufällige Datenaufteilung.

Trainierte ModelleAcht Detektoren unter CC BY-NC 4.0, für nichtkommerzielle Forschung.

Jedes gespeicherte Modell hat einen Wert aus seinem eigenen Testlauf, der vom Mittel aus drei Läufen oben abweicht. Die Modelldatei mit intensiver Augmentation ging verloren; die berichteten Ergebnisse bleiben erhalten.

Hugging FaceKaggle

Die neun Trainingsvarianten in Zahlen

Diese Werte vergleichen die neun Varianten der Studie. AUC misst die Rangfolge über verschiedene Schwellenwerte; F1 bewertet die Klassifikation am gewählten Schwellenwert.

AUC mit Augmentation und schwarzem Cutout; Mittelwert aus 3 Läufen
0,8971 ± 0,0064
Quelle
F1 derselben Variante; Mittelwert aus 3 Läufen
0,8429 ± 0,0101
Quelle
Veröffentlichte EfficientNet-B4-Modelle unter CC BY-NC 4.0
8
Quelle
FaceForensics++-Videos: 1.000 echte und 1.000 manipulierte
2.000
Quelle
Unbekannte DFDC-Videos im Test; Modell-AUC zwischen 0,60 und 0,66
398
Quelle
Die Erkennungsleistung sinkt, wenn diese Modelle unbekannte Videos prüfen.

Die ursprünglichen Varianten wurden mit unterschiedlichen, zufällig gezogenen Testaufteilungen ohne festen Startwert geprüft. Die Mittelwerte aus drei Läufen unterscheiden sich von den Einzellaufwerten der veröffentlichten Modelle. Grad-CAM zeigt Regionen, die mit einer Vorhersage zusammenhängen; eine Heatmap beweist keine Echtheit.

Diese Studie zitierenDOI der Masterarbeit und der veröffentlichte IEEE-UBMK-2026-Beitrag
@inproceedings{kaya2026augmentation,
  title     = {Augmentation and Cutout in Deepfake Detection: A Comparative Study of
               Accuracy, Calibration, and Attention},
  author    = {Kaya, Mert and Adanova, Venera},
  booktitle = {2026 11th International Conference on Computer Science and Engineering (UBMK)},
  pages     = {78--83},
  year      = {2026},
  publisher = {IEEE},
  doi       = {10.1109/UBMK71847.2026.11745298},
  url       = {https://ieeexplore.ieee.org/document/11745298}
}

@mastersthesis{kaya2025xdfdet,
  title  = {Explainable Deepfake Detection Using Frame Level CNN Models:
            A Comparative Study of Augmentation and Cutout Techniques},
  author = {Kaya, Mert},
  school = {TED University},
  year   = {2025},
  doi    = {10.5281/zenodo.18998566}
}

Fragen zur erklärbaren Deepfake-Erkennung

Wie vergleicht xdfdet die neun Trainingsvarianten?

Augmentation mit schwarzem Cutout erreicht in drei FaceForensics++-Läufen eine mittlere AUC von 0,8971, gegenüber 0,8678 für die EfficientNet-B4-Basisvariante. Dieser Vergleich gilt für das Experiment. Auf 398 unbekannten DFDC-Videos erreichen die veröffentlichten Modelle nur 0,60 bis 0,66 AUC. Der verwendete Evaluationsdatensatz beeinflusst das Ergebnis daher erheblich.

Wie erklärt xdfdet eine Deepfake-Vorhersage?

xdfdet verwendet Grad-CAM-Heatmaps, um Bildbereiche sichtbar zu machen, die mit einer Vorhersage zusammenhängen. Die Analyse misst die Aktivierung in acht Gesichtsregionen anhand von 68 Landmarken, darunter Augen, Augenbrauen, Nase, Mund und Kiefer. Damit lässt sich das Verhalten des Detektors untersuchen. Die Karten beweisen weder die Ursache einer Manipulation noch die Richtigkeit der Entscheidung.

Kann ich die xdfdet-Modelle herunterladen und lokal ausführen?

Acht EfficientNet-B4-Modelle stehen auf Hugging Face und Kaggle bereit. Installieren Sie das Python-Paket aus dem GitHub-Repository und führen Sie xdfdet predict für ein Video aus. Sie erhalten eine Echtheitswahrscheinlichkeit, ein Urteil und auf Wunsch ein Grad-CAM-Bild. Das Paket unterstützt Python 3.11 bis 3.13. Die Gewichte werden beim ersten Aufruf heruntergeladen; der Trainingsdatensatz ist für Vorhersagen nicht erforderlich.

Ist xdfdet für kommerzielle Deepfake-Erkennung kostenlos?

Der xdfdet-Code steht unter der MIT-Lizenz, die acht veröffentlichten Modellgewichte unter CC BY-NC 4.0. Sie wurden mit FaceForensics++ trainiert, dessen Bedingungen die Nutzung auf nichtkommerzielle Forschung beschränken. Sie können den Code prüfen und die Modelle zu Forschungszwecken einsetzen. Für die kommerzielle Nutzung der veröffentlichten Gewichte brauchen Sie die Zustimmung der jeweiligen Rechteinhaber.

Welchen Datensatz und welche Architektur verwendet xdfdet?

Die Studie verwendet 2.000 FaceForensics++-Videos: 1.000 echte Videos und 1.000 zugeordnete manipulierte Kopien. MTCNN erkennt und richtet die Gesichter aus, bevor sie auf 224 mal 224 Pixel zugeschnitten werden. EfficientNet-B4 bewertet zwölf Frames einzeln und mittelt ihre Werte zur Videovorhersage. Neun Trainingsvarianten verändern Augmentation und Cutout bei gleichbleibender Modellarchitektur.

Wo finde ich die Zitation für die xdfdet-Masterarbeit und den UBMK-Beitrag?

Mert Kayas Masterarbeit von 2025 an der TED University hat die DOI 10.5281/zenodo.18998566. Der Beitrag von Mert Kaya und Venera Adanova, Augmentation and Cutout in Deepfake Detection: A Comparative Study of Accuracy, Calibration, and Attention, wurde auf der UBMK 2026 in Istanbul vorgestellt und auf den Seiten 78 bis 83 in IEEE Xplore veröffentlicht. Die DOI lautet 10.1109/UBMK71847.2026.11745298. Verwenden Sie die BibTeX-Einträge dieser Seite.